저자: momo
개요
오클루전 컬링(Occlusion Culling)은 CPU와 GPU에서 근사 판정을 수행해 최종 이미지에 기여하지 않는 것으로 판단되는 오브젝트를 빠르게 제외하는 기술이다. 이를 통해 드로 콜(draw call), 깊이 테스트(depth testing), 오버드로(overdraw) 등의 비용을 줄일 수 있다. 일반적으로 상용 엔진에서는 오클루전 컬링이 기본으로 활성화되어 있으며, 많은 개발자는 장면 속 오브젝트가 원인을 알 수 없이 깜빡일 때가 되어서야 이 기능의 존재를 인식한다.
일반적인 렌더링 파이프라인(GPU-Driven이 아닌 경우)에서 GPU 오클루전 컬링은 CPU 프러스텀 컬링 이후에 수행된다. 현재 오브젝트가 뷰 프러스텀 안에 있으면 이전 프레임의 오클루전 결과를 읽는다. 가시 상태로 판단되면 드로 콜을 전송하고 해당 오브젝트를 현재 프레임의 오클루전 컬링 처리 대기열에 추가한다.
이 글에서는 먼저 오클루전 컬링의 원리를 설명한 다음, UE를 예로 들어 UE4의 두 가지 GPU 오클루전 컬링 방식인 하드웨어 오클루전 쿼리(Hardware Occlusion Query)와 HZB의 일부 구현을 살펴본다.
왜 오클루전 컬링이 필요한가?
첫 번째 의문은 이것이다. 최신 GPU에는 이미 Early-Z가 있고 모바일 GPU에는 HSR까지 있는데, 왜 여전히 오클루전 컬링이 필요할까?
가장 큰 이유는 역시 드로 콜이다. Early-Z 테스트가 가능한 대상은 이미 제출된 드로우(draw)다. 드로 콜 자체에도 PSO 전환, 디스크립터 바인딩, 각종 버퍼와 텍스처의 GPU 업로드 등 상당한 비용이 발생한다. 따라서 명백하게 보이지 않는 오브젝트를 미리 제거할 수 있다면 렌더 스레드와 드라이버의 부담을 크게 줄일 수 있다.
CPU 비용을 고려하지 않더라도 Early-Z 판정은 먼저 제출된 오브젝트가 깊이 값을 기록했는지에 의존한다. 따라서 드로 콜 정렬이 좋지 않으면 Early-Z의 효과도 떨어진다. 예를 들어 RTR에서 언급한 다음과 같은 극단적인 상황이 있다.
그리기 순서가 엄격한 전면→후면 순서가 아니면 오버드로가 발생한다.
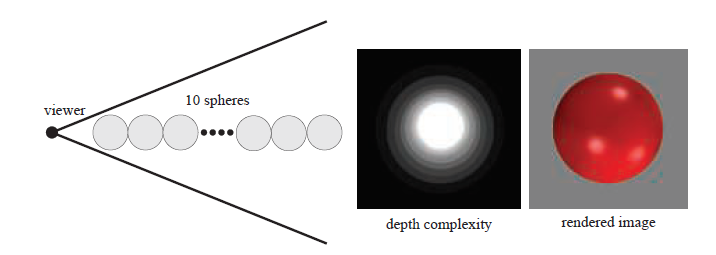
그리기 순서가 엄격한 전면→후면 순서가 아니면 오버드로가 발생한다
다행히 모바일 TBDR 아키텍처에서는 HSR이 비닝(binning) 이후 또는 비닝 도중에 드로 콜을 정렬하므로, 적어도 불투명 오브젝트에서는 오버드로가 발생하지 않도록 보장할 수 있다. 하지만 알파 테스트 및 알파 블렌드 오브젝트에는 HSR도 효과가 없다.
따라서 오클루전 컬링은 앞으로도 오랫동안 필요한 기술로 남을 것이다.
오클루더(depth buffer)는 어떻게 얻는가?
장면 속 오브젝트는 개념적으로 오클루더(occluder, 다른 물체를 가리는 물체)와 오클루디(occludee, 가려지는 물체)로 구분할 수 있다. 물론 모든 오브젝트는 다른 물체를 가리는 동시에 다른 물체에 가려질 수 있으므로 이는 어디까지나 개념적인 구분이다.
CPU에서 실행되는 SOC를 포함한 대부분의 런타임 오클루전 알고리즘은 특정 형태의 깊이 버퍼로 오클루더를 표현한다. 테스트 대상 오브젝트는 일반적으로 해당 오브젝트의 바운딩 박스를 사용한다.
앞에서 언급했듯 오클루전 테스트는 해당 프레임의 실제 드로 콜이 발행되기 전에 일어난다. 이 시점에는 아직 아무 오브젝트도 그려지지 않았는데 어떻게 깊이 정보를 얻을 수 있을까?
답은 이전 프레임의 깊이 또는 프리패스를 사용하는 것이다. 일반적으로 알려진 방식은 다음과 같다.
프리패스(Pre-Pass)
전체 프리패스를 사용할 수도 있고, 카메라에 가깝고 크기가 커서 좋은 오클루더가 될 수 있는 오브젝트만 그릴 수도 있다. 예를 들면 HLOD, 기타 프록시 메시, 뷰 렉트가 큰 불투명 오브젝트 등이다. 장점은 프레임 초반에 깊이 정보를 얻을 수 있다는 것이고, 단점은 프록시 메시를 그리는 비용이 추가된다는 점이다.
재투영(Re-Projection)
이전 프레임의 깊이를 재투영하는 방식이다. 마찬가지로 프레임 초반에 깊이 정보를 얻을 수 있다는 장점이 있다. 그러나 동적 오클루더에는 모션 벡터가 필요하며 빈 영역이 많이 생긴다. 이런 빈 영역은 오클루전 판정에 치명적이다. 빈 영역을 채우는 방법도 있지만 오클루전 판정이 더 이상 보수적(conservative)이지 않게 될 수 있다.
재투영된 깊이는 이미 부족한 깊이 버퍼를 더 불완전하게 만든다.
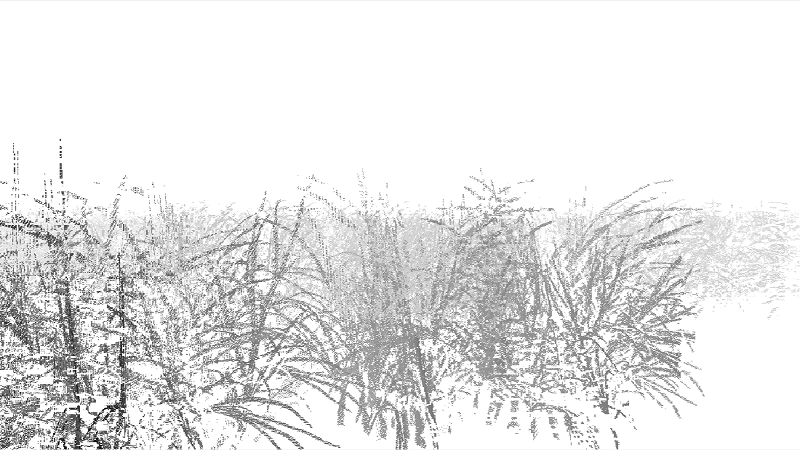
재투영된 깊이는 이미 부족한 깊이 버퍼를 더 불완전하게 만든다
베이스 패스(Base Pass)
불투명 오브젝트를 모두 그린 후 이미 만들어진 깊이 버퍼로 오클루전 테스트를 수행한다. 이 시점에는 깊이 정보가 매우 완전하므로 차폐율이 높다는 장점이 있다. 반면 프레임 중후반에 도달한 뒤이므로 결과를 CPU로 다시 읽을 때 한 프레임 정도의 지연이 추가될 수 있다.
2단계 오클루전 컬링(Two-Phase Occlusion Culling)
베이스 패스를 두 단계로 나눈다. 1단계에서는 이전 프레임의 깊이 피라미드로 컬링한 후 가시 오브젝트를 그린다. 2단계에서는 1단계에서 생성된 깊이로 깊이 피라미드를 갱신한 다음, 1단계에서 컬링된 오브젝트를 다시 테스트해 가시 오브젝트를 그린다.
GPU-Driven Rendering Pipelines, SIGGRAPH 2015
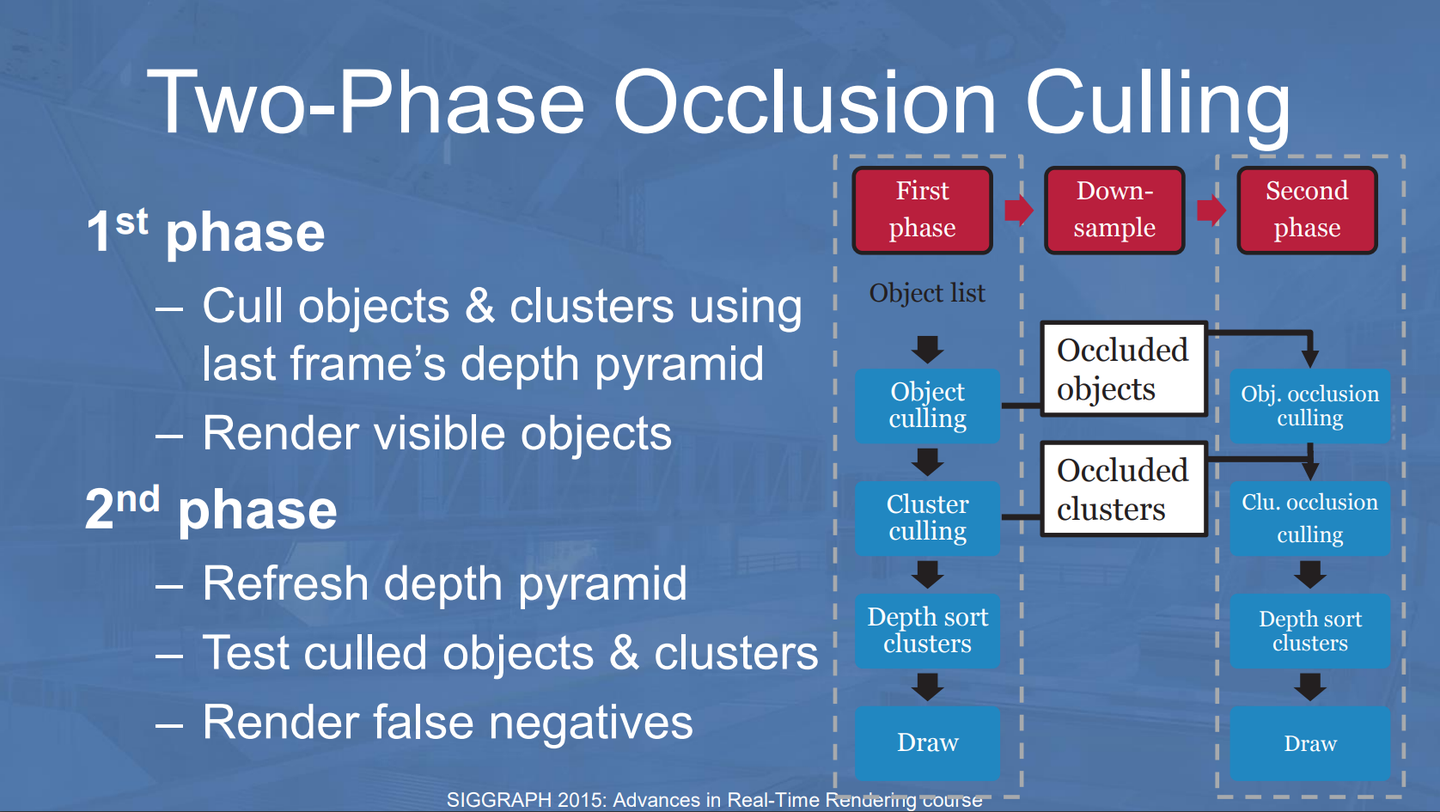
GPU-Driven Rendering Pipelines, SIGGRAPH 2015
현실적으로 고려해야 할 문제가 하나 있다. 오클루전 테스트 비용이 오브젝트를 컬링해 절약한 비용보다 크다면 컬링 자체가 의미가 없다. 일반적으로 메시 자체가 아니라 메시의 AABB로 오클루전을 계산하는 이유도 여기에 있다. 메시 자체를 사용하면 컬링률은 높아지지만 비용도 크게 증가한다.
단순한 오클루전 테스트 흐름
깊이 버퍼를 오클루더 정보로 확보한 뒤에는 오클루전 테스트를 수행한다. 가장 단순한 컬링 흐름은 다음과 같다.
- 어떤 방식으로든 깊이 버퍼를 확보한다.
- 프러스텀 컬링 후 남은 오브젝트를 순회한다.
- 프러스텀 안에 있는 오브젝트의 바운드를 테스트한다.
- 오클루전 테스트 결과를 기다린다.
- 쿼리 결과로 바운드의 가시성을 판단하고, 가시 상태라면 해당 오브젝트를 그리기 목록에 추가한다.
리드백과 지연 문제
CPU에서 실행하는 SOC, UE의 Precomputed Visibility Volumes 같은 사전 계산 방식, 그리고 뒤에서 언급할 수 있는 GPU-Driven 방식을 제외하면 오클루전 컬링은 대체로 CPU가 요청하고 GPU가 실제 차폐 계산을 수행한다. 이후 결과를 GPU에서 CPU로 읽어오고, CPU가 어떤 드로 콜을 제외할지 판단한 다음 가시 오브젝트의 드로 콜을 발행한다.
하지만 컬링을 요청한 직후 GPU 리드백을 기다리는 방식은 CPU와 GPU 모두에 비효율적이다. 이는 렌더 스레드와 GPU 사이에 동기화 지점(sync point)을 만드는 것과 같다. 렌더 스레드는 다른 로직을 처리하지 못하고, GPU도 렌더 스레드가 기다리는 동안 새로운 명령을 받지 못해 양쪽이 모두 스톨된다. Vulkan Samples의 다음 예가 이에 해당한다.
오클루전 쿼리를 제출한 직후 결과를 읽는 방식은 정확하지만 비효율적이다. 물론 LunarG 예제는 API 사용법을 설명하기 위한 것이므로 단순하게 작성되어 있다.
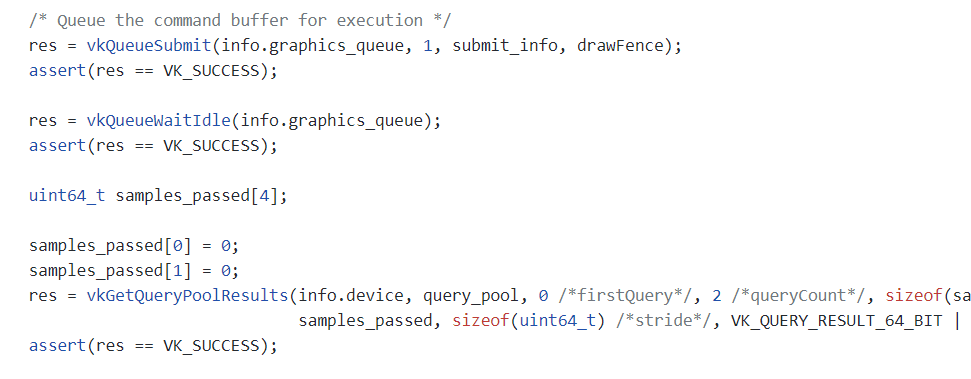
오클루전 쿼리를 제출한 직후 결과를 읽는 방식은 정확하지만 비효율적이다
RHI 스레드까지 활성화되어 있다면 CPU와 GPU 사이에 한 프레임이 더 추가되는 셈이다. 이 상태에서 동기화를 기다리면 CPU와 GPU의 병렬성을 완전히 잃게 된다.
더 효율적이지만 시각적 오류가 발생할 수 있는 방법은 이전 프레임, 경우에 따라서는 두 프레임 전의 오클루전 결과를 사용하는 것이다.UE도 이 방식을 사용한다. 그러면 GPU와 CPU를 비동기로 실행할 수 있다. 다음 프레임의 오클루전 쿼리를 발행한 후 과거 프레임의 쿼리 결과를 즉시 읽어 현재 프레임의 드로 콜을 준비한다.
UE의 오클루전 컬링 흐름은 대략 다음과 같다.
- 과거 프레임의 결과를 기다린다.
- 프러스텀 테스트를 통과한 오브젝트를 순회한다.
- 과거 프레임의 오클루전 테스트 결과로 바운드의 가시성을 판단한다.
- 현재 프레임의 오클루전 테스트에 추가한다.
- 깊이 버퍼를 확보한다. 일반적으로 프리패스를 사용하거나 불투명 패스 이후 하드웨어 오클루전 쿼리를 직접 수행한다.
- 현재 프레임의 오클루전 테스트를 수행하고 결과를 CPU로 읽은 뒤 해당 펜스를 설정한다.
또한 프러스텀 컬링 결과만 그대로 오클루전 처리에 넘기는 대신 과거 프레임 정보를 활용하면 일부 오브젝트의 오클루전 테스트를 생략해 비용을 줄일 수 있다.
간단한 통찰은 시간적 일관성(time coherence)을 활용하는 것이다. 이전 몇 프레임 동안 가려졌던 오브젝트는 다음 몇 프레임에서도 가려질 가능성이 높고, 보였던 오브젝트는 계속 보일 가능성이 높다. 예를 들어 이 글에서는 오클루전 쿼리를 배치 처리해 드로 콜 수를 줄였고, UE의 오클루전 쿼리 구현도 유사한 전략을 사용한다.
참고로 오클루전 컬링의 프레임 지연으로 발생하는 원인 불명의 깜빡임에 대해서는 필자도 아직 뚜렷하게 좋은 해결책을 찾지 못했다.
- 가장 단순한 방법은 컬링률을 낮추는 것이다. 바운드를 상수값으로 확장하거나 카메라 이동 속도에 따라 확장한다.
- 아트 리소스 단계에서 메시 단위를 조금 크게 만들고, 깜빡이기 쉬운 모서리나 문을 별도로 처리하거나 차폐판을 추가할 수도 있다.
- 근본적으로 GPU-Driven으로 전환할 수도 있다. 하지만 국내 게임의 아트 리소스, 특히 머티리얼은 초기 연구 단계부터 세밀한 규격을 정하는 경우가 드물다. 입사 시점에는 이미 리소스가 완성되어 있고, 장면을 캡처하면 서로 다른 머티리얼이 수백~수천 개에 달해 디퍼드 머티리얼로도 해결하기 어려운 상태인 경우가 많다.
- 렌더 스레드 시작 시점에 바로 HZB 테스트를 수행하고 결과를 기다릴 수도 있지만, CPU와 GPU 프레임 시간에 충분한 여유가 있어야 한다.
- 사전 계산 가시성(precomputed visibility)과 SOC를 결합하는 방법도 있지만 CPU는 오클루전 처리에 적합하지 않으므로 기술적으로 과거로 돌아가는 느낌이 있다.
UE 기본 오클루전 컬링 방식
이제 UE에서 구현된 두 가지 방식인 오클루전 쿼리와 업계에서 더 널리 사용하는 HZB를 소개한다. 먼저 개별 오브젝트를 처리하는 방식을 살펴본 뒤 UE의 전체 오클루전 컬링 흐름을 설명한다.
하드웨어 오클루전 쿼리(Hardware Occlusion Query)
하드웨어 오클루전 쿼리(HOQ)는 거의 모든 최신 GPU가 지원하는 오클루전 컬링 전용 기능이다. 특수한 형태의 드로 콜로 볼 수 있으며, 이 모드에서 그려지는 메시는 깊이 테스트 단계까지만 통과하고 픽셀 셰이더와 블렌딩 단계로 넘어가지 않는다. GPU는 깊이 테스트를 통과한 프래그먼트 수를 계산하고 그 결과를 CPU로 읽어 오클루전 결과로 사용한다.
일반적으로 오클루전 쿼리를 수행하기 전에는 블렌드 상태를 쓰기 비활성화로 설정하고, 깊이 테스트는 활성화하되 깊이 스텐실에는 기록하지 않도록 해야 한다. 해당 로직은 BeginOcclusionTests에 있다.
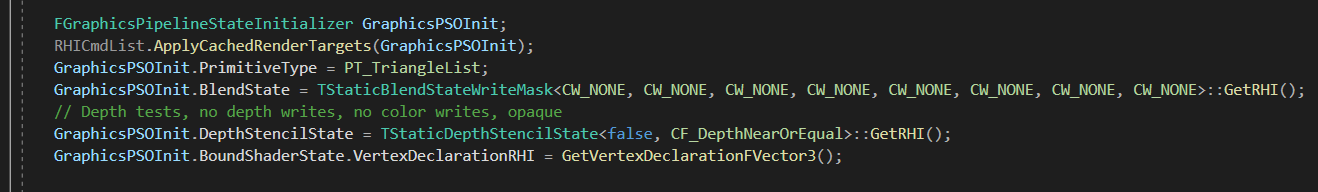
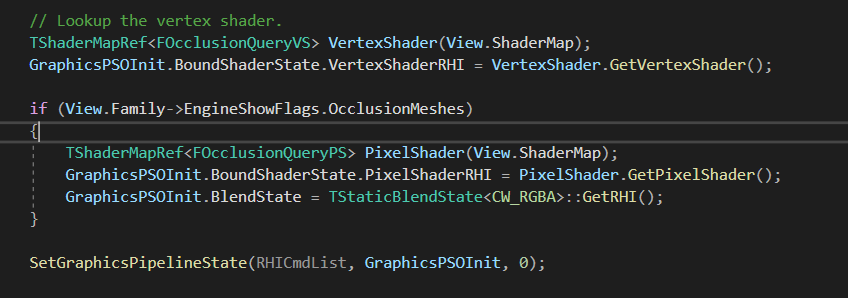
오클루전 쿼리에는 Early-Z만 필요하고 픽셀 셰이더 단계까지 실행할 필요가 없으므로 픽셀 셰이더를 바인딩하지 않는다. 또한 전체 오클루전 쿼리 패스는 모바일에서는 베이스 패스 뒤에 직접 드로우를 실행하기도 하며, 머티리얼에 따른 PSO 전환이 필요 없다. 따라서 오클루전 쿼리를 제출하기 전에 PSO를 한 번만 설정하면 된다.
HOQ를 사용할 때 GPU에 깊이 테스트를 통과한 프래그먼트 수를 집계하도록 하려면 드로 콜 시작과 종료 지점에서 해당 API의 begin/end query 함수를 호출해야 한다. Vulkan에서는 vkCmdBeginQuery와 vkCmdEndQuery가 이에 해당한다. UE에서는 RHI 레이어가 이를 감싸서 제공한다.
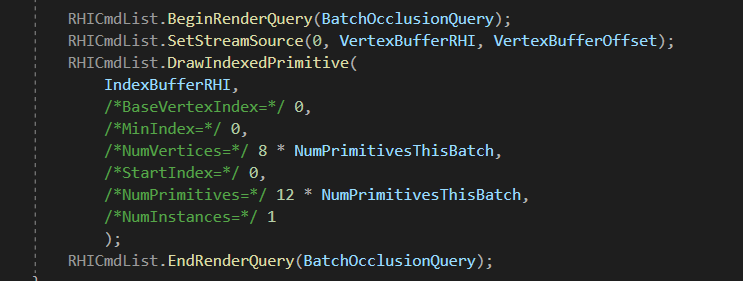
오클루전 쿼리의 명백한 문제는 드로 콜 수다. 실제 메시 드로 콜과 달리 오클루전 쿼리 사이에는 셰이더 구분이 없고 GPU 상태도 변하지 않으며 PSO를 전환할 필요도 없다. VB만 업로드한 뒤 드로우하면 되므로 실제 드로 콜보다 비용은 훨씬 작다. 그래도 너무 많은 드로 콜과 쿼리는 일정한 CPU·GPU 자원을 사용하며, 쿼리 결과를 CPU로 읽는 과정도 대역폭을 소모한다.
HOQ 드로 콜이 너무 많아지는 문제를 해결하기 위해 UE는 그룹 오클루전 쿼리(group occlusion query)라는 배치 처리 로직을 구현했다. 자세한 내용은 FOcclusionQueryBatcher::BatchPrimitive에서 볼 수 있다. 이전 프레임에서 보이지 않았던 메시의 바운딩 박스 일부를 동적으로 묶은 다음 하나의 쿼리로 합쳐 검사한다.
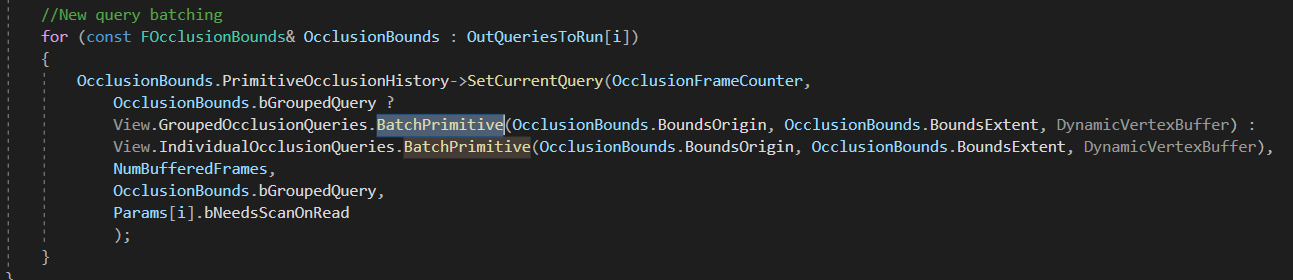
합쳐진 바운드는 하나의 쿼리로 테스트된다.
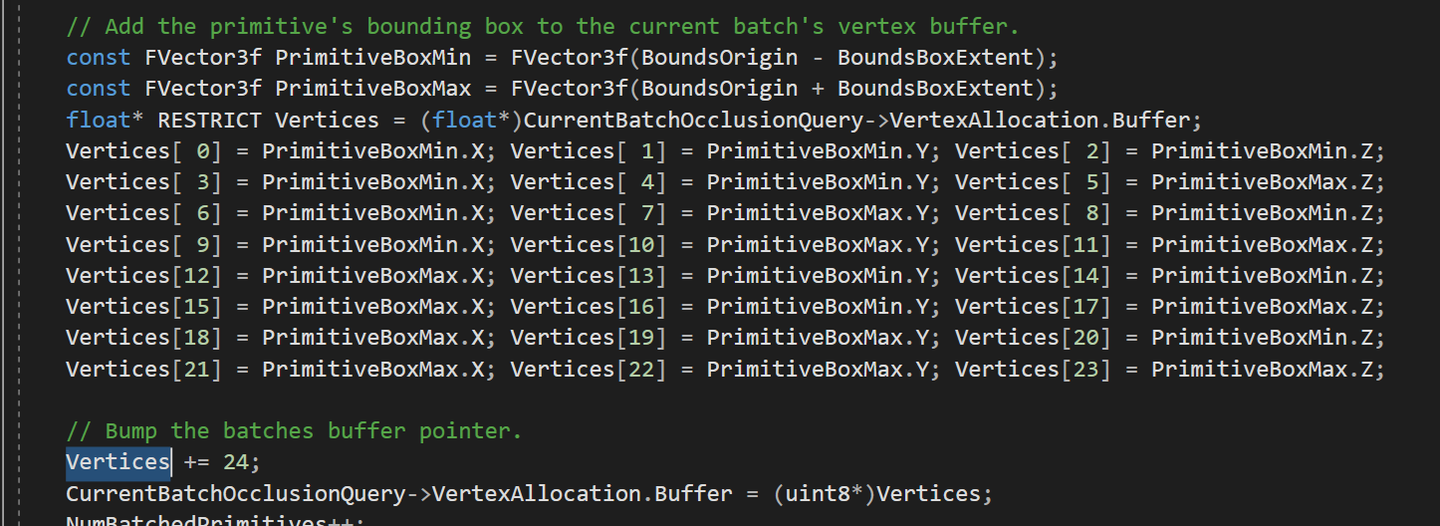
합쳐진 바운드는 하나의 쿼리로 테스트된다
하지만 합쳐진 바운딩 박스 전체가 하나의 오클루전 쿼리로 테스트되므로, 그중 하나라도 가시 상태면 같은 그룹의 다른 바운드도 가시 상태로 취급된다. 이 때문에 UE는 한 번에 묶을 수 있는 최대 바운드 수인 MaxBatchedPrimitives를 기본적으로 16으로 제한한다.
마지막으로 RHI를 통해 해당 결과를 직접 얻을 수 있다.
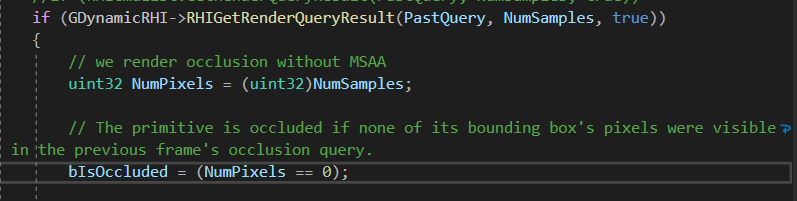
오클루전 쿼리는 GPU에서 깊이 테스트를 통과한 샘플 수를 직접 얻을 수 있다. 구형 그래픽 API에서는 해당 확장 기능의 지원이 필요하다. 단순 컬링이라면 샘플 수가 0인지 확인해 보이지 않는 것으로 판단하면 된다. 하지만 이 정보는 추가 판단에도 활용할 수 있다. 예를 들어 통과한 샘플의 비율에 따라 LOD를 선택하고, 화면에 몇 픽셀만 노출된 오브젝트에는 더 낮은 정밀도의 LOD를 적용할 수 있다.
FPrimitiveOcclusionHistory에는 마지막으로 보였던 시각이나 프러스텀 안에 있었던 시각 등 여러 과거 프레임 매개변수도 보존된다.
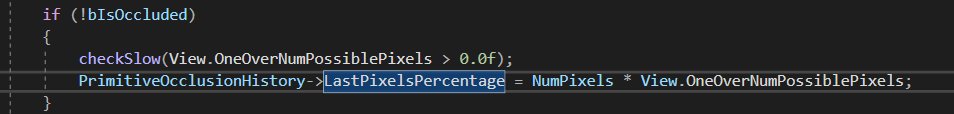
FPrimitiveOcclusionHistory에는 여러 과거 프레임 매개변수가 보존된다
오클루전 쿼리는 하드웨어 지원을 받고 대응 API도 있어 비교적 구현하기 쉽다. 상용 엔진에는 대체로 이미 구현되어 있다. 하지만 다음과 같은 단점도 있다.
- 유연성이 낮다. 컴퓨트 셰이더와 결합하기 어렵고 CPU가 바운드를 준비해야 하므로 버퍼에서 직접 읽을 수 없으며 GPU 프러스텀 컬링을 수행하기 어렵다.
- 쿼리 결과로 DrawIndirect를 직접 호출할 수 없어 GPU-Driven에 적합하지 않다. OpenGL에는 HOQ용 Conditional Rendering 기능이 있지만 여전히 CPU 리드백을 기다려야 한다.
- 테스트 시간은 제출한 바운딩 박스의 크기에 크게 영향을 받는다. 큰 바운드는 래스터라이즈와 깊이 테스트에 더 많은 시간이 필요하며 바운드 수가 늘면 쿼리 수도 증가한다.
- 같은 이유로 클러스터나 삼각형처럼 더 작은 단위의 컬링에는 거의 사용되지 않는다.
이러한 단점 때문에 오클루전 쿼리는 바운드 기준에서 픽셀 단위로 테스트할 수 있어 컬링률이 높음에도 많은 AAA 게임에서 사용되지 않는다. 대신 다음에 설명할 HZB가 더 널리 사용된다.
HZB(Hierarchical Z-Buffer) 오클루전
HZB 역시 깊이 버퍼를 기반으로 한다. 다만 오클루전 쿼리가 원본 깊이 버퍼에서 직접 래스터라이즈한 뒤 깊이 테스트 통과 여부를 판단하는 것과 달리, HZB는 먼저 깊이 버퍼의 밉맵을 생성한다. 이를 Z 피라미드라고 하며, 각 밉 레벨의 각 텍셀은 자신이 덮는 깊이 버퍼 영역의 오클루더 정보를 나타낸다.
가장 단순한 HZB 처리 흐름은 다음과 같다.
- 깊이 버퍼를 확보한다. 일반적으로 프리패스를 사용하며 이유는 뒤에서 설명한다.
- 깊이 버퍼의 Z 피라미드인 HZB를 생성한다.
- 바운드를 깊이 버퍼에 투영하고 화면 공간 크기에 따라 밉 레벨을 선택한다. 원칙적으로 해당 AABB가 최소 2×2픽셀을 덮을 수 있는 레벨을 사용한다.
- 바운드의 화면 공간 AABB에서 가장 가까운 깊이와 샘플링한 깊이의 가장 먼 값(Reverse-Z에서는 최솟값)을 비교해 차폐 여부를 판단한다.
참고로 UE5에서는 4×4를 사용한다. 바운드 투영 영역이 렌더 타깃 중심에 정확히 걸리면 최상위 밉의 한 픽셀만이 바운드의 전체 화면 공간 AABB를 덮을 수 있으므로 1픽셀만으로는 충분하지 않다.
깊이 버퍼의 밉맵, 즉 HZB는 다음과 같다.
아래 두 이미지는 각각 깊이 버퍼와 컬러 버퍼이며 왼쪽 위에는 생성된 밉이 표시된다.
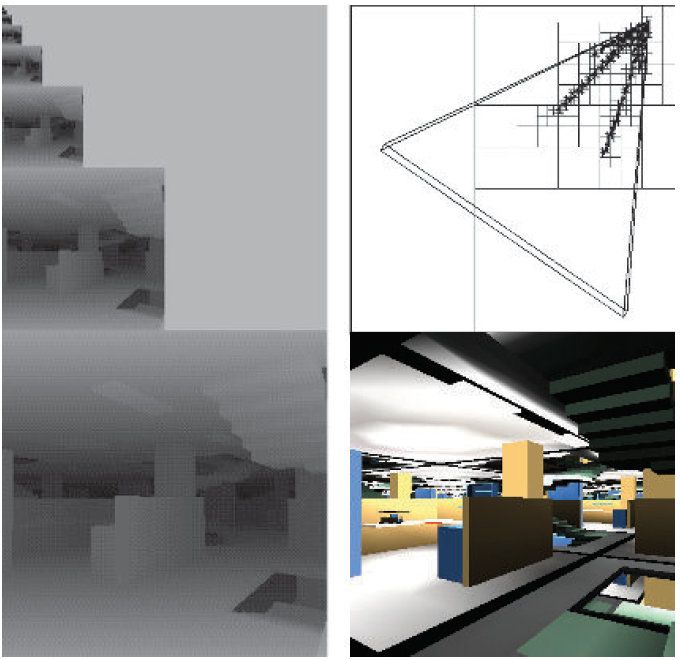
깊이 버퍼와 컬러 버퍼, 왼쪽 위의 생성된 밉
일반적인 밉맵이 원거리 픽셀 샘플링을 위해 네 픽셀의 평균값을 사용하는 것과 달리, HZB 밉맵은 해당 영역의 가장 먼 값을 사용한다. 이 영역에서 가장 먼 오클루더의 깊이조차 바운드의 가장 가까운 깊이보다 앞에 있다면 그 바운드는 확실히 보이지 않기 때문이다.
HZB는 일반적으로 컴퓨트 셰이더 또는 픽셀 셰이더로 생성한다.
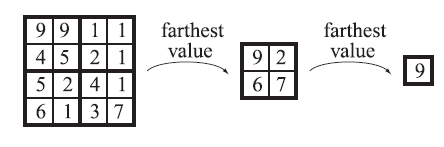
HZB는 일반적으로 컴퓨트 셰이더 또는 픽셀 셰이더로 생성한다
바운드 가시성을 판정하는 셰이더도 픽셀 셰이더 또는 컴퓨트 셰이더로 구현할 수 있다.
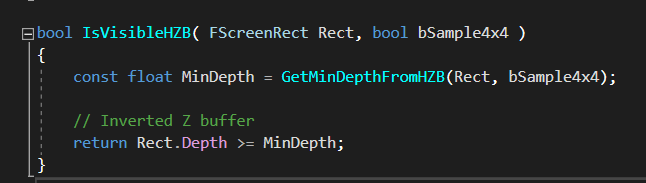
HZB에서 가장 먼 깊이를 읽어 바운드의 가장 가까운 깊이와 비교한다
이것이 앞에서 HZB에는 대체로 특정 형태의 프리패스나 이전 프레임의 깊이가 필요하며, 재투영만 단독으로 사용하는 경우가 적다고 설명한 이유다. 영역 안에 빈 곳이 하나만 있어도 해당 영역 전체의 컬링 효율이 크게 떨어진다. 재투영은 카메라가 빠르게 움직일 때 빈 영역을 많이 만든다. 필터로 재투영 깊이의 빈 곳을 줄일 수는 있지만 HZB가 더 이상 보수적인 판정을 보장하지 못하게 된다.
오클루전 쿼리가 RHI를 직접 조작하는 것과 달리 HZB는 거의 순수한 소프트웨어 방식이다. 대부분의 GPU 하드웨어 내부 깊이 테스트도 HZB와 비슷한 구현을 사용하지만, 현재 이를 직접 제어할 수 있는 범용 API는 없다.
일반적으로 Z 피라미드 생성과 HZB 테스트에는 픽셀 셰이더와 컴퓨트 셰이더 방식이 모두 있다. 컴퓨트 셰이더 버전은 공유 메모리를 사용해 텍스처 샘플링 횟수를 크게 줄이고 렌더 패스 수도 더 적다. 따라서 아주 오래된 하드웨어가 아니라면 대체로 컴퓨트 셰이더 버전을 사용한다. 자세한 내용은 HZB.usf를 참고한다.
HZB는 오클루전 쿼리의 여러 문제를 해결한다. 컬링 결과를 컴퓨트 셰이더에서 처리한 뒤 간접 인자 버퍼(indirect argument buffer)에 기록해 GPU-Driven을 지원할 수 있다. 컬링 단위도 바운드, 메시 클러스터, 삼각형 등으로 유연하게 선택할 수 있다. 이는 픽셀 단위 테스트가 가능한 오클루전 쿼리보다 HZB의 컬링률이 낮다는 단점을 보완한다.
다른 방식은?
추후 업데이트.
UE의 오클루전 컬링 프레임워크
먼저 디버깅에 자주 사용하는 콘솔 명령을 소개한다.
- r.AllowOcclusionQueries: 오클루전 컬링 활성화 여부를 결정한다.
- r.HZBOcclusion: 오클루전 쿼리 대신 HZB를 사용한다.
- r.VisualizeOccludedPrimitives: 에디터에서 컬링된 오브젝트의 바운드를 시각화한다. 장면에 오브젝트가 적을 때는 디버깅에 유용하지만 수가 많아지면 식별하기 어렵다.
- stat scenerendering: 드로 콜 수와 컬링에 소요되는 대략적인 시간을 확인한다.
UE의 오클루전 컬링 관련 코드는 주로 SceneVisibility.cpp와 SceneOcclusion.cpp에 있다. 하드웨어 오클루전 쿼리를 활성화한 UE5 프레임 캡처를 보면 전체 흐름을 대략 파악할 수 있다.
UE5 프레임 캡처
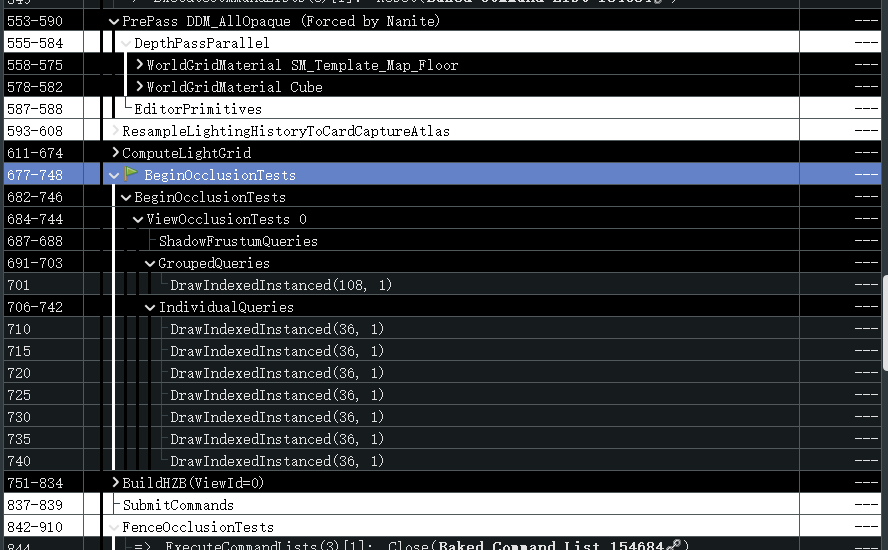
UE5 프레임 캡처
장면에서 Nanite가 활성화되어 있으므로 모든 불투명 오브젝트에 프리패스를 수행하고 HZB를 생성한다. Nanite는 비 Nanite 오브젝트가 사용하는 일반 컬링 흐름이 아니라 GPU-Driven 방식을 사용한다. 반면 일반 컬링을 사용하는 비 Nanite 스태틱 메시 등의 오브젝트는 BeginOcclusionTests에서 오클루전 쿼리 드로 콜을 발행한다.
디퍼드 파이프라인을 예로 들면 FDeferredRenderer::Render()가 호출하는 InitViews에서 과거 프레임의 가시성 결과를 읽고, 현재 프레임에서 오클루전 테스트가 필요한 신 프록시를 추가한다. 실제 처리는 FetchVisibilityForPrimitives에서 수행된다.
OcclusionCull에서 호출된다.

OcclusionCull에서 호출된다
사용하는 API가 RHI 스레드를 지원하고 해당 기능이 활성화되어 있다면 FetchVisibilityForPrimitives의 병렬 버전을 실행할 수 있다. 처리할 오브젝트를 네 개의 태스크 스레드에 나누고, 오클루전 테스트 대상 신 프록시 배열을 균등하게 분할한 뒤 각 태스크에서 FetchVisibilityForPrimitives_Range를 호출한다.
다만 RHI 스레드가 반드시 필요한 것은 오클루전 쿼리 쪽으로 보인다. HZB를 사용하고 CPU에 매핑된 HZB 결과에 태스크 스레드가 정상적으로 접근할 수 있다면 RHI 스레드가 없어도 병렬 실행이 가능하다. 단일 스레드 버전에서는 FetchVisibilityForPrimitives_Range를 직접 호출한다.
호출 스택. 캡처에서는 단일 스레드 버전이 실행되고 있다.
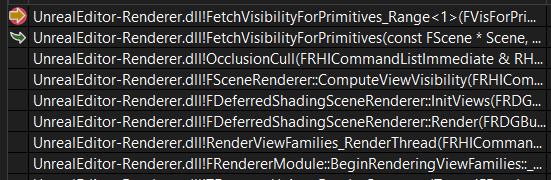
단일 스레드 버전의 호출 스택
FetchVisibilityForPrimitives_Range에서는 프러스텀 컬링 후 남은 프리미티브를 순회한다.
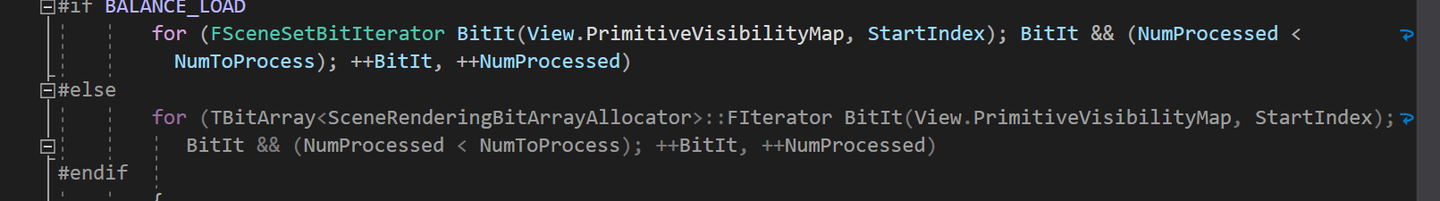
그런 다음 해당 프리미티브의 서브쿼리를 순회한다.
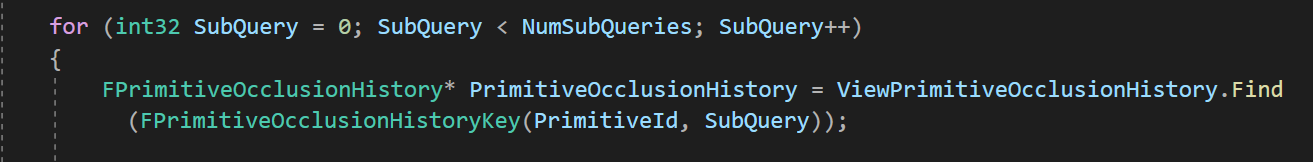
서브쿼리는 UE4가 일부 특수 프리미티브를 지원하기 위해 만든 구조다. 일반 스태틱 메시와 기타 일반 오브젝트에는 스태틱 메시의 바운드에 대응하는 하나의 서브쿼리만 존재한다.
반면 HISM(식생), 지형 등 컴포넌트 내부에서 메시를 직접 관리하는 경우에는 GetOcclusionQueries와 AcceptOcclusionResults 두 인터페이스를 오버라이드할 수 있다. 이를 통해 오클루전 컬링 시스템에 바운드를 전달하고 결과를 되돌려 받아 자체 컬링 및 렌더링 관리 로직을 구현한다.
FPrimitiveOcclusionHistory가 조회 키로 SubQuery를 필요로 하는 이유도 이것이다. 하지만 이 구조는 서브쿼리 순서에 암묵적인 제한을 둔다. 제출되는 각 바운드는 프레임 간 동일한 순서를 유지해야 한다. 이 때문에 실제 구현에는 여러 제약이 생기며, 컴포넌트 내부의 프러스텀 컬링에서 이미 제거된 하위 바운드까지 전달해야 하는 불필요한 비용이 발생한다.
각 신 프록시의 프레임 간 오클루전 기록은 FPrimitiveOcclusionHistory에 저장된다.
HZB와 오클루전 쿼리의 과거 결과 및 여러 과거 차폐 정보를 저장한다.
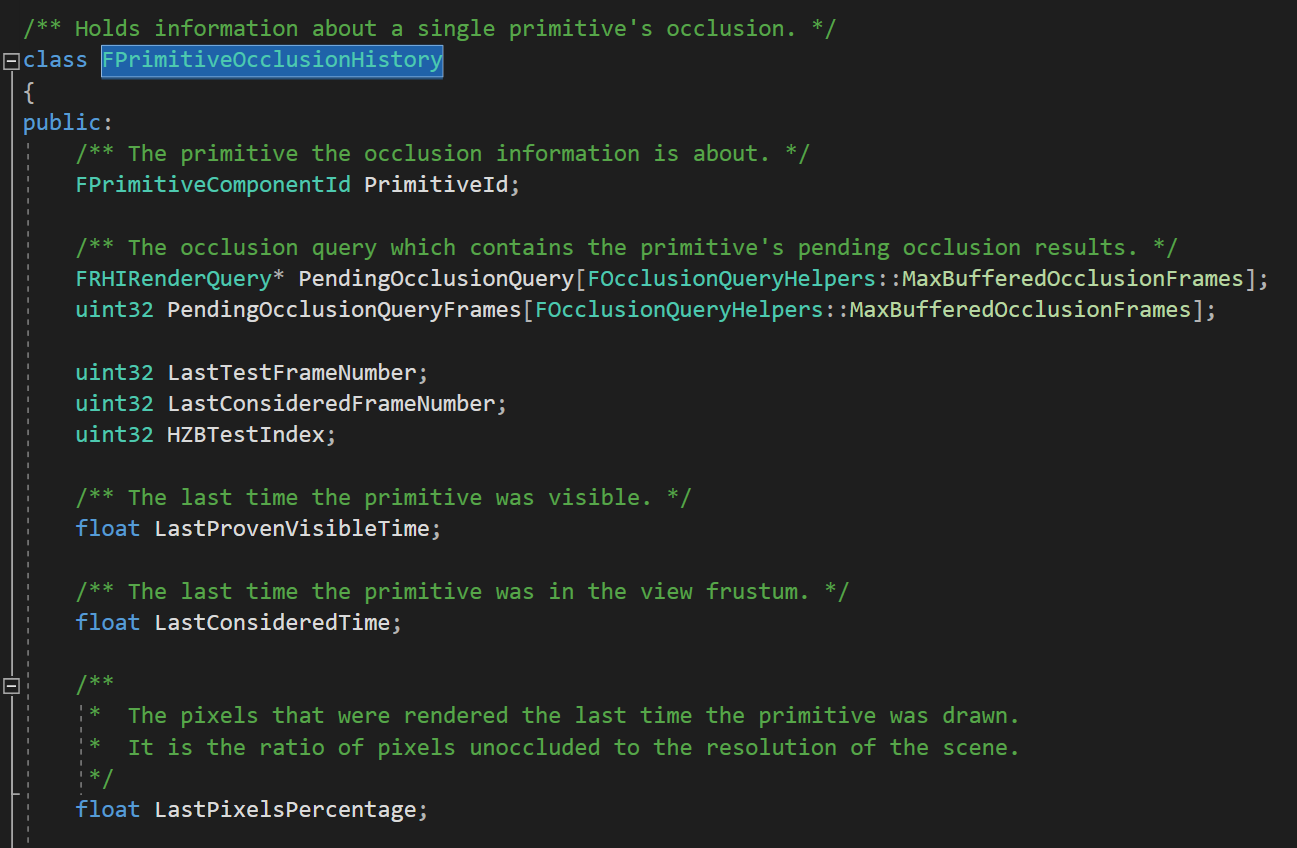
FPrimitiveOcclusionHistory에 저장된 과거 차폐 정보
SubQuery를 순회할 때는 먼저 대응하는 오클루전 기록이 있는지 확인한다. 기록이 없으면 새 기록을 만들고 해당 신 프록시를 가시 상태, 즉 가려지지 않은 것으로 간주한다. 기록이 있다면 과거 프레임의 결과를 조회한다. HZB를 예로 들면 다음과 같다.
HZB를 예로 드는 이유는 코드가 비교적 짧기 때문이다.
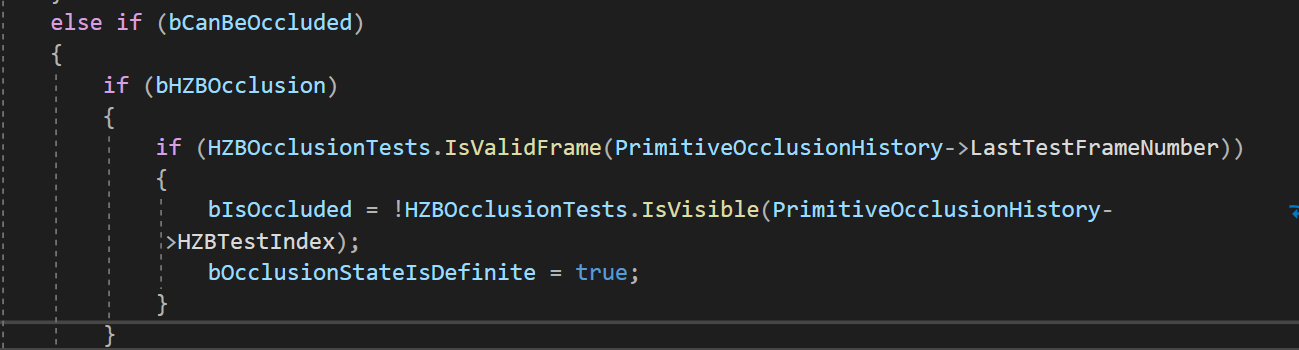
과거 프레임의 오클루전 결과를 읽은 뒤 FPrimitiveOcclusionHistory의 LastProvenVisibleTime 같은 데이터를 갱신하고, 현재 바운드가 이번 프레임의 오클루전 계산에 참여해야 하는지 판단한다.
조건은 매우 길지만 대체로 거리가 너무 멀지 않아야 하고 니어 클립 평면과 교차하지 않아야 한다는 내용이다.
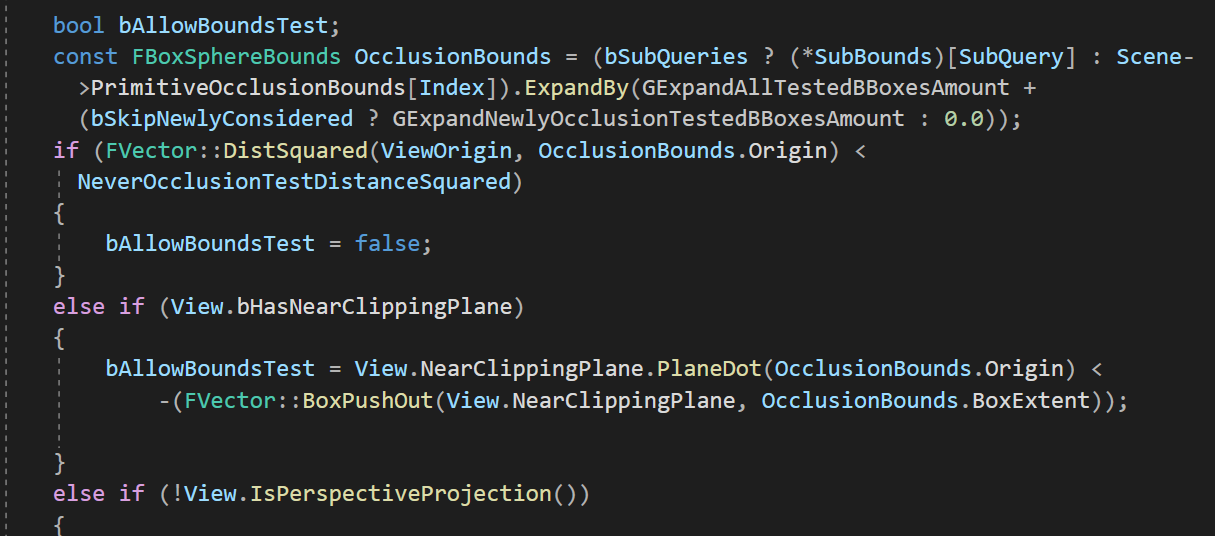
현재 바운드의 오클루전 계산 참여 여부 판정
마지막으로 bAllowBoundsTest와 관련된 일련의 테스트를 모두 통과하면 현재 프레임의 오클루전 컬링에 최종적으로 추가된다.
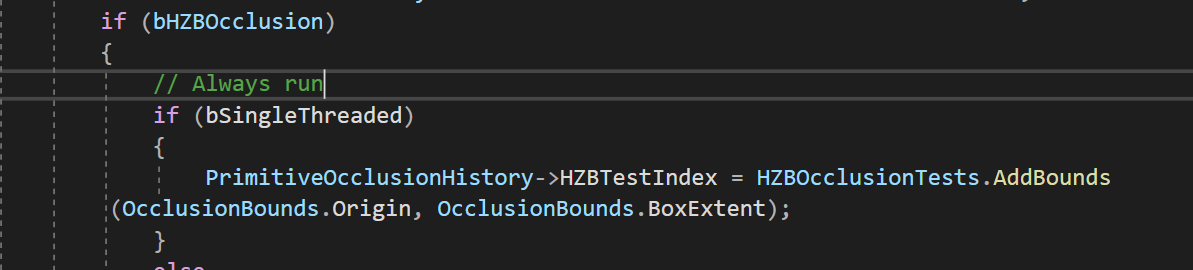
이로써 오클루전 컬링의 주요 흐름은 대체로 마무리된다.
후기
오클루전 컬링을 접한 이후 필자는 많은 최신 파이프라인이 GPU-Driven으로 전환되는 이유 중 하나가 메시를 더 세밀하게 컬링할 수 있고 성가신 프레임 지연 문제도 적기 때문이라고 생각해 왔다.
하지만 모바일 환경에서는 GPU-Driven에 필요한 기능의 지원이 부족하거나 효율이 낮은 경우가 많다. 바인드리스 지원률은 높지 않고, DrawIndirect 비용은 크며, VT를 수정 없이 그대로 사용하면 문제가 생길 가능성이 높고, MultiDrawIndirect는 아예 사용하기 어려운 경우도 있다.
따라서 모바일 게임 개발 현장에서 GPU-Driven을 적극적으로 활용하더라도 결국 원경 건물, 물, 지형처럼 머티리얼이 비교적 단순한 일부 모듈에만 적용하고 끝날 가능성이 높다. 전면적인 GPU-Driven 적용은 쉽지 않다. 머티리얼 관리가 어렵고 협업 비용이 크며 디퍼드 머티리얼 구현도 부담스럽기 때문이다. 결국 오클루전 컬링을 조금씩 수정하며 성능을 유지하는 현실적인 선택으로 돌아오기 쉽다.
참고 자료
- Real-Time Rendering, Fourth Edition
- Platform/GFX/MobileGPUs
- GPU-Driven Occlusion Culling Slides
- GPU-Driven Rendering Pipelines, SIGGRAPH 2015
- Intel Software Occlusion Culling
- UE4 Software Occlusion Queries
- UE4 Precomputed Visibility Volume
- GPU-Driven Rendering Pipelines 자료
- Vulkan Samples: Occlusion Query
- GPU Gems: Efficient Occlusion Culling
- CHC++: Coherent Hierarchical Culling Revisited
- OpenGL Conditional Rendering
- Hierarchical Z-Buffer Visibility
원문
(83 封私信 / 58 条消息) UE4/5 遮挡剔除(Occlusion Culling)浅析 - 知乎
'TECH.ART.FLOW.IO' 카테고리의 다른 글
| [리뷰] NoGraphicsAPI: 그래픽스 API의 미래를 다시 쓰다 (0) | 2026.09.07 |
|---|---|
| [YOUTUBE] Substrate Subsurface Scattering - Unreal Substrate - Episode 5 (0) | 2026.09.07 |
| [Siggraph2026] Adaptive Tessellation and SubdivisionJohn Hable (0) | 2026.09.06 |
| [번역] 《더 서지 2》의 바인드리스 디퍼드 데칼 일괄 렌더링 (0) | 2026.09.01 |
| [번역] UE5 애니메이션 샘플 프로젝트 보행 처리 — GASP FootPlacement (0) | 2026.09.01 |